LGS
1.1 Matrizen
Note
Matrizen sollen nicht unter dem Bruchstrich geschrieben werden
Lineare Kombination
Standardbasis
Standardbasis von -dimensionalem Koordinatensystem bestehet aus Vektoren der Form:
Sie bilden die Identitätsmatrix
1.2 Gauss-elimination
Note
- Die Eliminationsschritte machen nur lineare Kombinationen von Gleichungen
Protokollmatrix
Bildet die Operationen der Gauss-elimination ab. Ist am Anfang eine Diagonalmatrix.
- Vertauschen zweier Zeilen:
- In der Protokollmatrix werden die entsprechenden Zeilen vertauscht.
- Multiplizieren einer Zeile mit :
- Alle Elemente einer Zeile in der Protokollmatrix werden mit derselben Zahl multipliziert.
- Addieren eines Vielfachen einer Zeile zu einer anderen Zeile:
- Die entsprechende Zeile in der Protokollmatrix wird durch die Summe der ursprünglichen Zeile und dem Vielfachen der anderen Zeile ersetzt. ( todostimmt das ?)
Rang einer Matrix
Der Rang einer Matrix , notiert als , ist die Anzahl der Pivote der Matrix nach der Gauss-Elimination.
- freie Variablen Spalten sind lineare Kombinationen der jeweils vorigen Spalten
Lösungsdiskussion
Rang Anzahl Variablen
Note
Verträglichkeit Kompatibilitätsbedinungen
- Verträglichkeit (KB) erfüllt -> genau eine Lösung
- nicht erfüllt -> keine Lösung
- Verträglichkeit (KB) erfüllt -> unendlich viele Lösungen
- nicht erfüllt -> keine Lösung
Alle KB müssen erfüllt sein, damit das LGS mindestens eine Lösung hat
Satz 1.2.0.20.
Für ein lineares Gleichungssystem mit Matrix und gilt: Falls es eine Lösung gibt, ist diese eindeutig dann und nur dann, wenn .
Homognes LGS
Ein homogenes LGS hat genau dann nicht triviale Lösungen () wenn
Reguläre/Singuläre Matrix
heisst
- regulär (voller Rang)
- Rang(A) = 𝑟 = 𝑛
- Für jedes b gibt es genau eine Lösung
- Ax = 0 hat nur x = 0 als Lösung
- heisst singulär (nicht voller Rang)
- Rang(A) = 𝑟 < 𝑛
- Für gewisse b gibt es keine Lösung
- Für kein b gibt es eine eindeutige Lösung
- Ax = 0 hat nicht triviale Lösungen
1.3 Operation mit Matrizen
(Hermite) transponierte Matrix
für
- Zeilen und Spalten werden vertauscht ->
- Hermite transponierte Matrix ()
- alle einträge werden zu ihren komplex Konjugiereten
Matrixaddition
alle Einträge der Matrizen an gleicher Position werden addiert
Eigenschaften:
- kommutativ
- assoziativ
- ist neutrales Element
Matrixmultiplikation
Seien
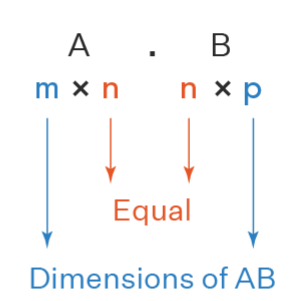
So ist die Multiplikation der Matrix A B die ZUsammenstellung der Multiplikation von mit jedem Spaltenvektor von zu
- der Rang von ist der Kleinste Rang der Faktoren
- nicht kommutativ
- ist ein neutrales Element
Eigenschaften:
- assoziativ
- distributiv bezüglich ""
spezielle Fälle:
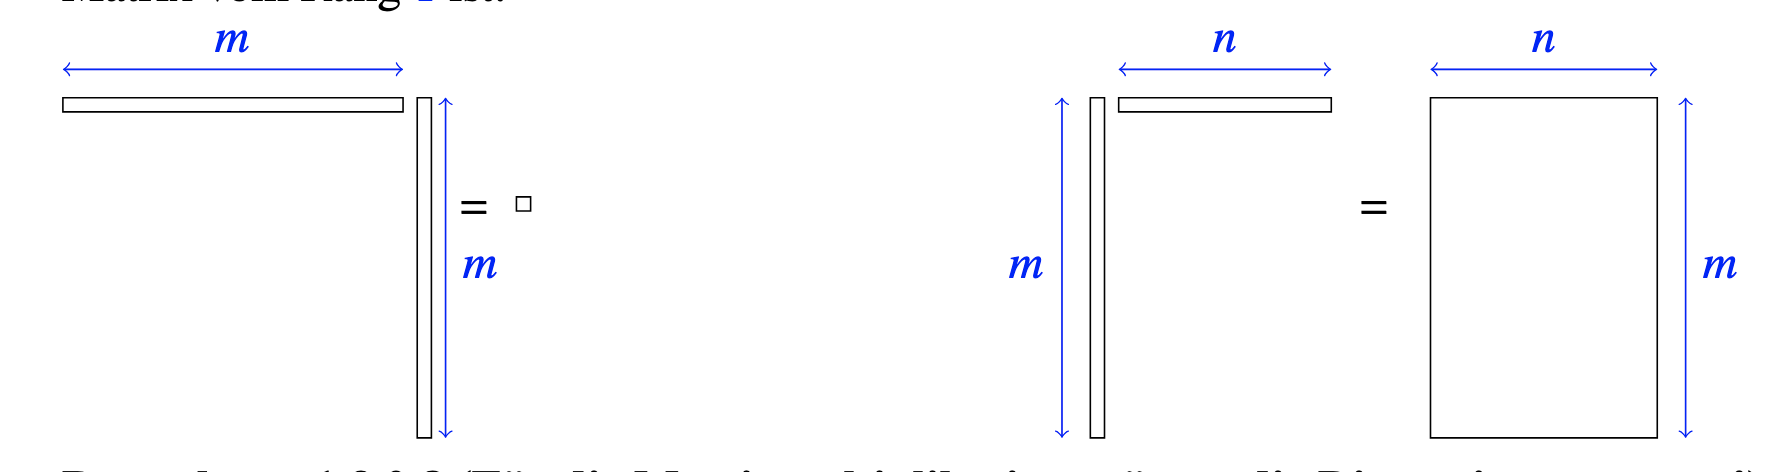
Matrixpotenz
Sei
LGS
Ein lineares Gleichungssystem (LGS) wird kurz geschrieben als:
wobei die Koeffizientenmatrix, die Unbekannte und die rechte Seite ist
1.4 Inverse matrix
- Inverse Matrizen gibt es nur, wenn
- regulär ist
- ist eindeutig
Eigenschaften:
1.6 LU-Zerlegung
Note
- Das Gauss-Jordan-Verfahren wandelt
- Protokollmatrix (Diagonalmatrix) (untere Dreiecksmatrix)
- (obere Dreiecksmatrix)
- wobei
- Falls bei der Gauss-elimination auch Zeilen vertauscht wurden, bekommt man noch , die Permutationsmatrix, und es gilt:
Determinante
Produkt der Diagonalelemente nach der Gauss-Elimination der quadratischen Matrix
Eliminationsmatrix
ist die Matrix, welche man aus der Identitätsmatrix mit an der Stelle in erhält.
realisiert den Schritt in der Gauss-Elimination, in welchem die -te Gleichung mit multipliziert wird und zur -ten Gleichung hinzuaddiert wird.
sparsame LU-Zerlegung
Die Gauss-Elimination von einer beliebigen Matrix () lässt sich als LU-Zerlegung schreiben, falls
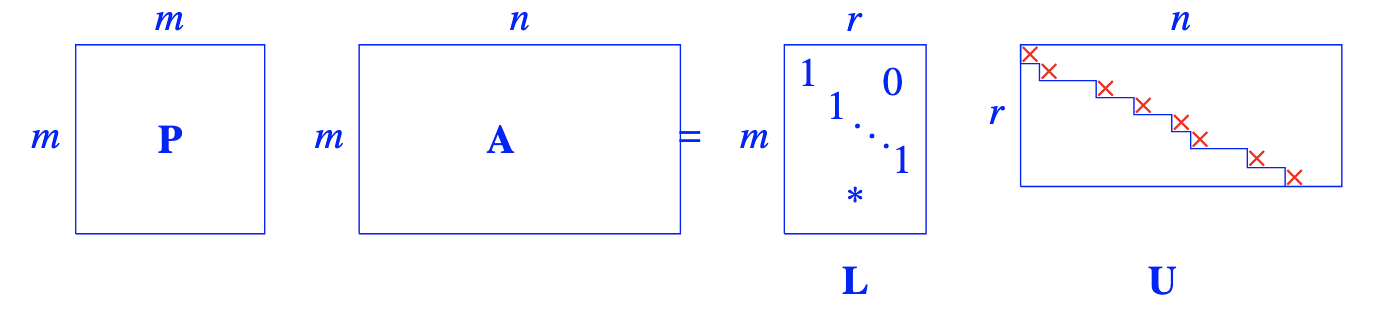
Blockweise Gauss-Elimination
LDU-Zerlegung
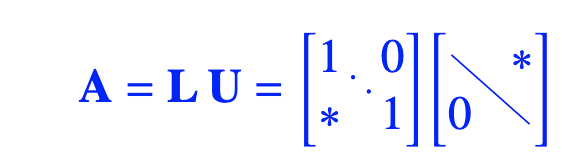 Da beliebige Werte auf der Diagonale hat, führen wir ein, welche die Diagonalwerte von auf der Diagonale hat. Ausserdem führen wir ein, sodass
(falls die Diagonaleinträge )
Cholesky-Zerlegung
Zerlegen man in zwei Matrizen
Kombiniert mit der LDU-Zerlegung:
Das ist eine obere Dreiecksmatrix
1.7 Orthogonale Matrizen
euklidische Form
x \in \mathbb{R}^n, ||x||=\sqrt{ x_{1}^2+ x_{2}^2+\dots+x_{n}^2 }
Skalarprodukt
x,y\in \mathbb{R}^n, <x,y>=x_{1}y_{1}+\dots+x_{n}y_{n} = x^\top y
Winkel
\hat{(x,y)}=\arccos{\frac{<x,y>}{||x||||y||}}
Orthogonalität
- Zwei Vektoren sind orthogonal, wenn
- Eine reelle Matrix heisst orthogonal, wenn
- alle Spalten stehen $\bot$ aufeinander und haben Länge ==1==.
- Orthogonale Matrizen verändern Länge und Winkel nicht.
Orthogonale Operationen zweier Matrizen
- A ist invertierbar,
- ist orthogonal
- ist orthogonal
- ist orthogonal
Bsp:
- Drehmatrix
- Permutationsmatrizen
- Spiegelmatrizen
Drehmatrizen
Matrix, welche einen Vektor um dreht (abbildet).
- Um zurückzudrehen, kann man anwenden, oder .
- , d.h. die Drehmatrix ist orthogonal.
- kann für 𝑛 Dimensionen erweitert werden:
- Die Matrix, die eine Rotation in der 𝑖- 𝑗 Ebene eines 𝑛 dimensionalen Raumes ausführt, gleicht überall der Identitätsmatrix, ausser in den 𝑖-ten, 𝑗-ten Spalten und Zeilen, in denen die Rotationsmatrix für den zweidimensionalen Raum eingefügt wird.
- Dadurch kann eine komplexe Drehung in mehrere einfache Drehungen im 2D-Raum aufgeteilt werden.
Die Drehung in der Ebene ist:
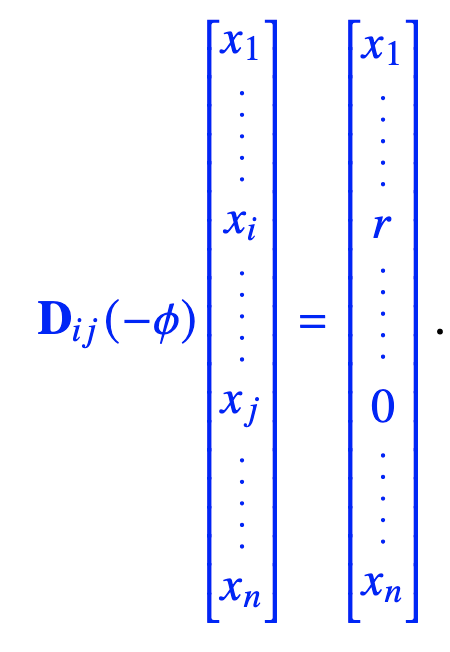 wobei
Spiegelung mittels Householder-Matrix
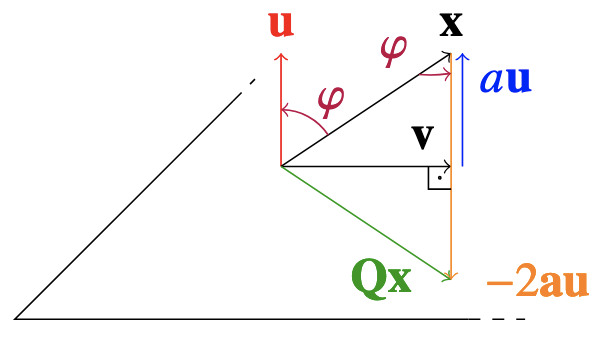 Der Skalar . Mit ihm berechnet ist (und auch alleine)
falls (nicht Norm 1), dann muss mit gerechnet werden.
- Die Householder-Matrix ist orthogonal
QR-Zerlegung
Um Rundungsfehler zu vermeiden, braucht es eine neue Zerlegungsart. Die QR-Zerlegung ist die Zerlegung einer Matrix in eine orthogonale Matrix und eine obere Dreiecksmatrix , so dass .
Dabei muss die Drehmatrix für jede 0 einzeln angewendet werden.
Die Zerlegung mit Spiegelung erzeugt alle Nullen in einer Spalte gleichzeitig.
todo Satz 1.8.0.6
2 Lineare Räume/Vektorräume
2.1 Raum und Unterraum
Def Vektorraum
Ein reeller Vektorraum / linearer Raum ist eine Menge mit zwei Operationen:
- Addition von Elementen aus
- Multiplikation mit Skalaren
Eigenschaften:
- Kommutativität
- Assoziativität
- Es existiert ein Nullvektor
- für jedes gibt es ein (), sodass
- Kompatibilität mit der Multiplikation mit Skalaren
- Distributivität (für Sklare und Vektoren)
- Es existiert ein Neutralemenent
Funktionen in linearen Räumen
Bsp: Der Raum der -Mal stetig differenzierbaren Funktionen im Intervall .
Mit dieser -Notation können verschiedene Mengen, deren Elemente Funktionen sind, definiert werden. Die Mengen sind ineinander verschachtelt:
”+” von Funktionen: Für , , wobei k-mal differentierbar und stetig
”*” von Funktionen: Für , :
Beweis Linearer Raum
Überprüfen, ob addition und multiplikation erfüllt ist (in derselben Menge bleibt) -> linearer Raum
Beispiele
Räume von Polynomen
Raum der quadratisch integrierbaren Funktion
wobei , da die Mitglieder von weniger Glattheit haben müssen
Unterraum
Def. Unterraum
Sei ein linearer Raum mit . Dann heisst Unterraum von , falls gilt:
- wenn , dann auch
- wenn , dann auch
- Der Unterraum enthält immer das Element
- jede beliebige lineare Kombination von Elementen von liegt in
- Die Verschachtelung von linearen Räumen:
Untervektorraum prüfen
- gibt es einen Nullvektor
- ist abgeschlossen unter Addition
- ist abgeschlossen unter Multiplikation (mit Skalar)
alternativ: Falls die Lösungsmenge eines homogenen LGS ist, ist es ein Unterraum, z.B.
2.2 Erzeugendensystem
Def Lineare Kombination
Eine lineare Kombination der Elemente eines lineares Raumes ist
mit Skalaren . Eine lineare Kombination lässt sich mithilfe der Elemente von und gewählten Skalaren darstellen.
Def Span
Wir bezeichnen die Menge aller linear Kombinationen von Elementen mit
Wir sagen, dass aufgespannt/erzeugt wird von
Bild einer Matrix
eine Matrix Vektor Multiplikation ist eine lineare Kombination der Spaltenvektoren der Matrix: ,
wir können es auch als Abbildung betrachten:
Def Bild
Die Menge aller Bildelemente einer Abbildung heisst Bild der Abbildung.
- Die Abbildung ist das Bild der Matrix
-> Das Bild von wird von deren Spalten erzeugt
Erzeugendensystem
Def Erzeugendensystem
Falls sich jedes eines linearen Raumes als lineare Kombination von schreiben lässt, ist diese Menge das Erzeugendensystem von :
Kern einer Matrix
Def Kern einer Matrix
Der Kern einer Matrix () ist die Menge der Vektoren , sodass
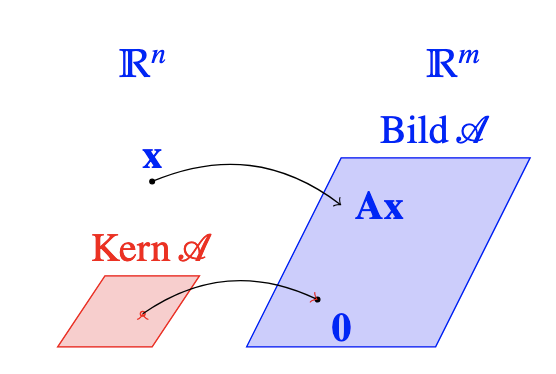
- Das ist die Lösungsmenge eines homogenen LGS
- Kern ist ein Unterraum von
todo Berechnung von Bild, Kern im Skript anschauen -> zu lang zum übertragen in Zusammenfassung https://moodle-app2.let.ethz.ch/pluginfile.php/2131293/mod_resource/content/7/LAVG.pdf#section.2.3
endlichdimensionale lineare Räume
Def Endlichdimensionale lineare Räume
Ein linearer Raum heisst endlichdimensional wenn es eine endliche Menge gibt, die erzeugend für ist.
- sind endlichdimensionale Räume
- sind nicht endlichdimensional
2.3 Lineare Unabhängigkeit und Basis
Für linearer Raum, möchten wir die Menge haben, mit der sich alle anderen Elemente erzeugen lassen. Falls sich ein Element durch andere Elemente erzugen lässt, liefert es keine neuen Information, weshalb wir es ausschliessen können.
Def Lineare Unabhängigkeit
Die elemente eines linearen Raumes sind lineare unabhängig, falls
x_{1}v_{1}+x_{2}v_{2}+\dots+x_{n}v_{n}=0 \implies x_{1}=x_{2}=\dots=x_{n}=0
Durch die Gauss-elimination lässt sich herausfinden, ob die Spalte n einer Matrix linear (un)abhängig sind. Nur ween der Rang der Matrix voll ist, ist sie linear unabhängig.
Satz 2.3.0.4. Linear unabhängige Spalten einer Matrix
Die Spaltenvektoren einer Matrix sind linear unabhängig genau dann wenn der Rang der Matrix ist.
Def 2.3.0.5 Basis
Eine linear unabhängiges Erzeugendensystem eines linearen Raumes heisst Basis von .
Bsp
- kanonische Basis/Standardbasis:
- Monome bilden eine Basis
Def 2.3.0.7. Dimension linearer Raum / Grösse Basen
- verschiedene Basen haben gleich viele Vektoren
- Wenn eine Basis in V viele Elemente hat, dann ist dimensional!
todo beweis anschauen, zusammenfassen
Satz 2.3.0.10. Grösse von erzeugenden Systemen in einem endlichdimensionalen Raum
Sei ein linearer Raum mit Dimension , dann:
- sind mehr als Elemente von linear abhängig.
- sind weniger als Elemente von nicht erzeugend.
- sind Elemente von linear unabhängig genau dann, wenn sie auch erzeugend sind.
2.4 Fundamentalsatz der linearen Algebra - Teil 1
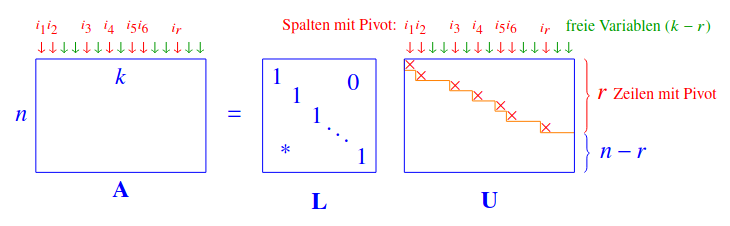
Satz 2.4.0.1 Basis im Bild A
Sei die LU-Zerlegung der Matrix . Wir notieren die Indizes der Pivotspalten in mit . Die dazugehörigen Spalten aus linear unabhängig. Alle anderen Spalten von A lassen sich als lineare Kombinationen von schreiben, welche somit eine Basis im Bild bilden.
-> Oder: sind linear unabhängig
Bem:
Satz 2.4.0.4 Dimension von Kern A
Sei die Matrix , Matrix von Rang . Dann:
\begin{align} dim(\text{Kern}~A)&=k-r \ dim(\text{Kern }A^\top)&=n-r, dim(\text{Bild }A^\top)=r \end{align}
> [!tip] Def 2.4.0.6 Orthogonalität von Unterräumen > > Seien $U$ und $V$ Unterräume von $\mathbb{R}^k$. Wir sagen, dass $U$ orthogonal auf $V$ stehe, notiert mit $U\bot B$, falls beliebige Vektoren $u$ aus $U$ und $v$ aus $V$ orthogonal sind ($u\bot v$), d.h. mit Skalarprodukt in $\mathbb{R}^k$: > $$ <u,v> = u^\top v=0
Satz 2.4.0.7 Fundamentalsatz der linaren Algebra - Teil I.
Sie eine Matrix vom Rang . Dann hat die Matrix auch Rang und:
- Dimensionen der Unterräume:
\begin{align} \ \dim (\text{Kern}~A)+\dim (\text{Bild}~A^\top)=k \ \dim (\text{Kern}~A^\top)+\dim (\text{Bild}~A)=n \end{align}
**Bem**: Zudem kann jedes $x \in \mathbb{R}^k$ eindeutig in zwei orthogonale Komponenten zerlegt werden:
x=u+v, u \in \text{Kern}~A, v \in \text{Bild}~A, u\bot v
**Theorem**: 1. $\text{Kern}~(A^\top A)=\text{Kern}~A$ 2. $\text{Bild}~(A^\top A)=\text{Bild}~(A^\top)$ > [!note] Bestimmung von lin. Abhängigkeit > > Jede Matrix kann durch Gauss-Elimination (und vertauschung von Zeilen und Spalten) in die folgende Form gebracht werden: >$$ P_{Z}AP_{S}\begin{bmatrix} \begin{array}{c|c} \begin{matrix} 1 & 0 & \dots\\ 0 & 1 \end{matrix} & * \\ \hline 0 & 0 \end{array} \end{bmatrix} >$$ > $P_{Z}$ ist dabei die Zeilen-Prozessmatrix, und $P_{S}$ die Spalten-Prozessmatrix ## 2.5 Koordinaten und Basiswahl **Satz 2.5.0.1:** Jedes element eines linearen Raumes $x \in V$ lässt sich als lineare Kombination der Basis von $V$ eindeutig darstellen. > [!tip] Def 2.5.0.2 Koordinatenabbildung und Koordinaten > > Sei $V$ ein linearer raum mit $\dim(V)=n$, $\mathscr{B}$ dessen Basis >$$ \begin{align} \mathscr{k_{B}}:V &\to \mathbb{R}^n \\ x=x_{1}v_{1}+\dots+x_{n}v_{n} &\mapsto \mathscr{k_{B}}:=\begin{bmatrix} x_{1} \\ \vdots \\x_{n} \end{bmatrix} \end{align} >$$ >$\mathscr{k_{B}}$ ust die Koordinatenabbildung in der Basis $\mathscr{B}$, $x_{1},\dots,x_{n}$ sind die Koordinaten von $x$ inder Basis $\mathscr{B}$. > #todo Beispiele in Aufschrieb W5, letzte zwei Seiten # 3 Lineare Abbildungen > [!tip] Def 3.1.0.1 Lineare Abbildung > > $X,Y$ lineare Räme, $\mathscr{F}:X\to Y$ > $\mathscr{F}$ ist linear, falls > 1. $\mathscr{F}(x_{1}+x_{2})=\mathscr{F}(x_{1})+\mathscr{F}(x_{2})$ für alle $x_{1}, x_{2} \in X$ > 2. $\mathscr{F}(ax)=a\mathscr{F}(x)$ für $x \in X$, $a$ Skalar > > -> ein linearer raum ist abgeschlossen unter Addition und Multiplikation **Bsp** Matrixabbildung\mathscr{A}: \mathbb{R}^k\to \mathbb{R}
$A$: $k\times n$ Matrix #todo fetigschreiben **Bem** Bei Aufgaben mit Isomorphismen/Automorphismen erkennen muss man vor allem (einzig) die Dimensionen anschauen! # 4 Norm und Skalarprodukt in linearen Räumen ## 4.1 Normierte lineare Räume > [!tip] Def 4.1.0.1. Norm > > Sei 𝑉 ein linearer Raum. Die Funktion $||\cdot||:V\to[0,\infty[$ heisst Norm in 𝑉, falls sie folgende Eigenschaften erfüllt: > 1. Aus $||v||=0$ folgt $v=0$. > -> Der Einzige Vektor von Länge $0$ is der Nullvektor > 1. Sei $a$ ein Skalar und $v \in V$ beliebig. Dann gilt: $||av||=|a|||v||$. > 2. Für beliebige $v,w \in V$ gilt: $||v+w||\leq ||v||+||w||$ (Dreiecksungleichung). > [!tip ] Def 4.1.0.2 Normierte Lineare Räume > > Ein linearer Raum $V$, welcher eine Norm $||\cdot||$ besitzt, heisst normierter linearer Raum **Bsp** - **euklidische Norm**: $||x||_{2} = \sqrt{ x_{1}^2+x_{2}^2+\dots+x_{n}^2 }=\sqrt{ x^\top x }$ - **Normen in $\mathbb{R}^2$**: $1\leq p<\infty$ fest: $||x||_{p}=(|x_{1}|^p+\dots+|x_{n}|^p)^{1/p}$ - **Norm in L$^2$:** $L^2(0,1)$: $||f||_{2}=\sqrt{ \int_{0}^1 |f(t)|^2dt }$ Die Bedeutung der Norm eines Vektors ist die Länge. Ein Ball sieht in den verschiedenen Normen anders aus, weil die jede Norm eine andere Länge des Vektors hat:B(0,r)={ x \in V ; ||x||\leq r }
![[HS2024/attachments/Pasted image 20241102130511.png|300]] > [!note] Satz 4.1.0.4 Cauchy-Bunjakowski-Schwarz Ungleichung > > $$ > v^\top w \leq ||v||||w|| > $$ > [!note] Satz 4.1.0.6 Äquivalenz der Normen > > Alle Normen in $\mathbb{R}^d$ sind äquivalent. In anderen Worten: > Seien $||\cdot||$ und $|||\cdot|||$ Normen in $\mathbb{R}^d$, dann gibt es eine Konstante $C\geq 1 ~(\text{bem:}~C=C(d))$, abhängig von der Dimension $d$, so dass > $$ > \frac{1}{C}||v||\leq |||v||| < C||v||~\text{für alle}~v \in \mathbb{R}^d > $$ > [!tip] Def 4.1.0.8 Matrixnorm aus der Vektornorm > > DIe Vektornorm $||\cdot||$ in $\mathbb{R}^n$ induziert im linearen Raum der $m \times n$ Matrizen eine Norm: > $$ > ||A||=\max_{||x||=1}||Ax|| > $$ **Bsp** Matrixnormen: - Zeilensummen-Norm (maximum der Zeilensumme):||A||{\infty}=\max{||x||{\infty}=1} ||Ax||{\infty}=\max_{i=1,\dots,n} \sum_{j=1}^n |a_{ji}|
||A||{1}=\max{||x||{1}=1} ||Ax||{1}=\max_{j=1,\dots,n} \sum_{i=1}^n |a_{ji}|
||A||{F} = \sqrt{ \sum{i,j=1}^n |a_{ji}|^2 }
- Spektralnorm ($\lambda$ ist der grösste Eigenwert von $A^HA$):||A||{2}=\max{||x||{2}=1}||Ax||{2}=\sqrt{ \lambda_{\max}(A^HA) }
## 4.2 Skalarprodukt in linearen Räumen > [!tip] Def 4.2.0.1 Skalarprodukt > > Sei $V$ ein inearer Raum. > EIn Skalarprodukt $<.,.>$ ist eine FUnktion von zwei Variablen in diesem Raum $V$ > $$ > <.,.>: V \times V \to \mathbb{R} > $$ > welche die folgenden drei Eigneschaften erfüllt.: > 1. Die funktion ist linear im zweiten Argument: > $$ > <x,ay+bz = a<x.y>+b<x,z> > $$ > für alle $x.y.z \in V$ und $a,b$ Skalare > 2. Die Funktion ist Symmetrisch: > $$ > <x,y> = <y,x>\quad \text{über}~\mathbb{R} > $$ > $$ > <x,y> = \overline{<y,x>}\quad \text{über}~\mathbb{C} > $$ > 3. Die funktion ist positiv definit: > $$ > <x,x> \geq 0 ~\text{für alle}~x \in V > $$ > $$ > <x,x\geq 0 \implies x=0 > $$ > falls von (3) nur ein punkt erfüllt ist $\implies$ positiv semi-definit > [!tip] Def 4.2.0.4 Norm aus einem Skalarprodukt > > Man sagt, dass eine Norm $||\cdot||$ aus einem Skalarprodukt $<.,.>$ kommt, falls > $$ > ||x||=\sqrt{ <x,x> } > $$ > für alle Elemente $x$ eines linearen Raumes $X$. > [!tip] Def 4.2.0.5 Orthogonalität von Elementen eines linearen Raumes mit Skalarprodukt > > Sei $x,y \in V$, wobei $V$ ein linearer Raum mit einem Skalarprodukt $<.,.>$ ist. Wir sagen, dass $x$ und $y$ orthogonal $(x\bot y)$ sind, falls $<x,y>=0$ **Bsp**: A-Skalarprodukt<u,v>_{A} \stackrel{def}{=} u^\top A v \in \mathbb{R}
wobei $A=Q^\top \Lambda Q$, $\Lambda$ eine Diagonalmatrix ohne $0$ in der Diagonale und $Q$ eine orhogonale quadratische Matrix. ### Orthogonale Projektionen **Bem**: Siehe Def 4.2.0.5 für orthogonalität > [!tip] Def 4.2.0.9 Orthogonale Projektion auf einen Vektor > > Sei $V$ ein linearer Raum mit einem Skalarprodukt $<.,.>$. So ist die orhogonale Projekiton $P_{y}x$ von x$x \in V$ auf $y \in V$, für $y\neq_{0}$, definiert als > $$ > P_{y}x = \frac{<y,x>}{<y,y>}y > $$ **Bem:**\text{Bild}(P_{y})=\text{Span}{ y }
\begin{align} v&=P_{e_{1}}v+P_{e_{2}}v+\dots+P_{e_{n}}v \ v&=\sum_{j=1}^n <b_{j},v>b_{j} \ v&=\sum_{j=1}^n P_{b_{j}}v \end{align}
> [!note] Satz 4.2.0.20 Parseval > > Das Skalarprodukt in $V$ lässt sich über das euklidischen Skalarprodukt in $\mathbb{R}^n$ berechnen: > $$ > <x,y\geq x^Hy=<x,y> > $$ **Bem** 4.2.0.21 (Projektion auf einen Unterraum) #todo fertigschreiben ## 4.3 Gram-Schmidt-Algorithmus > [!note] Satz 4.3.0.1. Gram-Schmidt > > Wenn 𝑉 ein linearer Raum mit Basis $\{ v_{1},v_{2},\dots,v_{n} \}$ und Skalarprodukt $<.,.>$ ist, dann gibt es eine orthonormale Basis (ONB) $\{ q_{1},q_{2},\dots,q_{n} \}$ für $V$, so dass $\text{Span}\{ q_{1},q_{2},\dots,q_{n} \}=\text{Span}\{ v_{1},v_{2},\dots,v_{n} \}$ für $1,2,\dots,n$ ist. **d.h.** - ein endlich-dimensionaler Raum besitzt immer eine orthonormale Basis - die orthogonalen Vektoren bilden verschachtelte Räume > [!help] #todo: Der Beweis zum Gram-Schmidt-Algorithmus zeigt, wie man orthogonale Vektoren berechnet -> anschauen > **Beweis** Bedignungen für $q_{1}$ sind, dass es Norm 1 haben muss, und den gleichen Unterraum wie $v_{1}$ aufspannen muss, d.h.\begin{align} q_{1}&=\frac{1}{||v_{1}||}v_{1} \ v_{1}&=||v_{1}||q_{1}= < q_{1},v_{1}>q_{1} \end{align}
![[HS2024/attachments/Pasted image 20241110133922.png]] Nun für $q_{2}$:\begin{align}
c_{2}&=v_{2}-P_{q_{1}}^\top v_{2}=v_{2}-<q_{1},v_{2}>q_{1} \
q_{2}&=\frac{c_{2}}{||c_{2}\} \
&\implies c_{2}=||c_{2}||q_{2} = \left< q_{2},v_{2} \right> q_{2} \
&\implies v_{2} = \left< q_{1},v_{2} \right>q_{1} + \left< q_{2},v_{2} \right>q_{2}
\end{align}
\begin{align} c_{k}&=v_{k}-P_{Span{ q_{1},\dots,q_{k-1} }}^\top v_{k}=v_{k} - \left< q_{1},v_{k} \right>q_{1}- \dots-\left< q_{k-1},v_{k} \right> q_{k-1} \ q_{k}&=\frac{c_{k}}{||c_{k}||} \ &\implies c_{k} = ||c_{k}||q_{k}= \left< q_{k},v_{k} \right> q_{k} \ &\implies v_{k} =\left< q_{1},v_{k} \right>q_{1}+\dots+\left< q_{k-1},v_{k} \right> q_{k-1} \end{align}
**QR-Zerlegung mittels Gram-Schmidt** Sei $A$ eine Matrix mit der Basis $\{ v_{1},v_{2},\dots,v_{n} \}$. Dann können wir $v_{k}$ als lineare Kombination schreiben:v_{k} = (q_{1}^Hv_{k})q_{1}+(q_{2}^Hv_{k})q_{2} + \dots+(q_{k}
Für alle Elemente $v$ in der Basis können wir dann schreiben:\underbrace{ \begin{bmatrix}
v_{1} & v_{2} & \dots & v_{k}
\end{bmatrix} }{ A{k} (n\times k) } = \underbrace{ \begin{bmatrix}
q_{1} & q_{2} & \dots & q_{k}
\end{bmatrix} }{ Q{k}(n\times k) } = \underbrace{ \begin{bmatrix}
q_{1}^Hv_{1} & q_{1}^Hv_{2} & \dots & q_{1}^Hv_{k} \
0 & q_{2}^Hv_{2} & \dots & q_{2}^Hv_{k} \
& \dots \
0 & 0 & \dots & q_{k}^Hv_{k}
\end{bmatrix} }{ R{k}~(k\times k) }
P_{y}^\top:V\to V;\quad P_{y}^\top x=\frac{\left< y,x \right>}{\left< y,y \right> }y
Den wir als Matrix $P_{y}$ schreiben können, falls der lineare Raum $\mathbb{R}^n$ oder $\mathbb{C}^n$:P_{y}^\top=\frac{y}{||y||} \frac{y
> [!tip] Def 4.4.0.1. Projektor > > Sei 𝑉 ein linearer Raum. Eine lineare Abbildung $\mathscr{P}: V\to V$ heisst Projektor falls > $$ > \mathscr{P}^2=\mathscr{P} > $$ > [!tip] Def 4.4.0.2. Orthogonale und schiefe Projektoren > > Der Projektor $\mathscr{P}:V\to V$ im linearen Raum 𝑉 mit dem Skalarprodukt $\left< .,. \right>$ heisst orthogonaler Projektor, falls > $$ > x-\mathscr{Px}\bot \text{Bild}~\mathscr{P}~\text{für alle} x \in V > $$ > sonst heisst er schiefer Projektor. > [!note] Satz 4.4.0.3. Orthogonale und schiefe Projektoren > > Der Projektor $\mathscr{P}:V\to V$ im linearen Raum $V$ mit dem Skalarprodukt $\left< .,. \right>$ ist ein orthogonaler Projektor genau dann, wenn > $$ > \left< x,\mathscr{P}y \right> = \left< \mathscr{P}x,y \right> ~\text{für alle}~x,y \in V > $$ > d.h. wenn der Projektor $V$ ein selbstadjungierter Operator ist. > [!note] Satz 4.4.0.4. Orthogonale und schiefe Projektoren > > Die Matrix $P$ ist ein orthogonaler Projektor genau dann, wenn > $$ > P^2=P~\text{und}~P^H=P > $$ > Falls nur die Bedingung $P^2=P$ erfüllt ist, so ist $P$ ein schiefer Projektor. **Bsp** #todo anschauen, wie man skizze von schiefem Projektor aussieht > [!tip] Def 4.4.0.7. Orthogonaler Projektor auf einen Unterraum > > Sei $U$ eine $n\times k$ Matrix mit orthogonalen Spaltenvektoren $q_{1},\dots,q_{k}$ welche Norm $1$ haben. Der orthogonale Projektor $P$ welche auf den Unterraum $\text{Span}\{ q_{1},\dots,q_{k} \}$ projiziert ist > $$ > P=UU^H > $$ **die folgenden Definition wurden nicht behandelt:** > [!tip] Def 4.4.0.7. Orthogonaler Projektor auf einen Unterraum > > Sei $U$ eine $n\times k$ Matrix mit orthogonalen Spaltenvektoren $q_{1},\dots,q_{n}$ welche Norm 1 haben. Der orthogonale Projektor $P$ welche auf den Unterraum $Span\{ q_{1},\dots,q_{k} \}$ projiziert ist > $$ > P=UU^H > $$ > [!tip] Def 4.4.0.9. Schiefer Projektor auf einen Unterraum > > Wenn $U$ und $V$ zwei Matrizen mit der Eigenschaft $V^HU=I$ sind, dann kann ein schiefer Projektor $P$, welcher auf den Unterraum der Spaltenvektoren von $U$ projiziert, definiert werden als > $$ > P=UV^H > $$ ### Zusatz: Lineares Funktional > [!tip] Lineares Funktional > > Sei $V$ lin. Raum über $\mathbb{R}/\mathbb{C}$. Das lineare Funktional ist dann > $$ > \varphi: V\to \mathbb{R}/\mathbb{C}\quad (\text{linear}) > $$ **Bsp** $V=C[0,1]$ $\varphi: C[0,1]\to \mathbb{R}$, $\varphi(f)=f\left( \frac{1}{2} \right)$ > [!note] Theorem (Riesz) > > $V,~<.,.>$, dim $V<\infty$. Sei $\varphi:V\to \mathbb{R}/\mathbb{C}$ ein lineares Funktional. > 1. Es gibt ein eindeutiges $w \in V$ sodass $\varphi(w)=<w,v>$ für alle $v \in V$ > 2. Sei $b_{1},b_{2},\dots,b_{n}$ ONB in $V$. Dann > $$ > w = \sum_{i=1}^n \overline{\varphi(b_{i})}b_{i} > $$ > -> $w$ hängt nicht von der Wahl der Basis ab, da es dann nicht eindeutig wäre **Bsp**\vec{v}=\begin{bmatrix} v_{1} \ v_{2} \v_{3} \end{bmatrix} \in \mathbb{R}^3,\quad \varphi(v)=v_{1}
ONB: $\{ e_{1},e_{2},e_{3} \}$w=\varphi(\vec{e_{1}})\vec{e_{1}}+\varphi(\vec{e_{2}})\vec{e_{2}}+\varphi(\vec{e_{3}})e_{3}=\vec{e_{1}}
#todo andere Beispiele im Aufschrieb Woche 8 anschauen ### Zusatz: Die adjungierte Abbildung Seien $V,<.,.>_{v}$, $W,<.,.>_{w}$ lineare Räume über $\mathbb{R} / \mathbb{C}$ mit s.p. > [!ip] Def adjurgierte Abbildung > > $f:W\to V$ ist die adjungierte Abbildung einer Abbildung $T:V\to W$, wenn > $$ > <T_{v},w>_{w} = <v,f(w)>v > $$ > für alle $v \in V$, $w \in W$ **Bem** $f,g:W\to V$ und $<v,f(w)> = <v,g(w)>$ für alle $v \in V, w \in W$, dann $f=g$ Konsequenz: $T:V\to W$ lin. Abbildung => es gibt maximal eine adj. Abbildung! #todo beispiele im Aufschrieb W8 anschauen > [!note] Theorem > > Wenn $T:V\to W$ lin. Abbildung hat eine adjungierte $T^*$: > dann ist $T^*$ linear. - Nicht jede lin. Abb. hat eine adj. Abbildung! > [!note] Theorem > > $V,<.,.>_{v},\quad W,<.,.>_{w},\quad\dim V=n,\quad\dim W=m$ > $\{ v_{1},\dots,v_{n} \}$ ONB in $V$, $\{ w_{1},\dots,w_{n} \}$ ONB in $W$ > $$ > F:V\to W \lim. \leadsto F=[<F v_{j},w_{j}] > $$ > 1. $F$ hat eine adj. Abbildung > 2. $F^*$ ist von $F^H$ representiert # 5 Ausgleichsrechnung Berechnen der bestmöglichen Approximation von komplexen Systemen ## 5.1 Least Squares > [!tip] Def 5.1.0.2. Lineare Ausgleichsrechnung als lineares Gleichungssystem > > Sei eine $m\times n$ Matrix $A$ und der Vektor $b$ mit $m$ einträgen. Gesucht ist ein $\hat{x}$, sodass > $$ > ||A\hat{x}=b||_{2} = \min_{x \in \mathbb{R}^n}||Ax-b||_{2} > $$ **Bsp** lineares Modell - Parameter: $d \in \mathbb{R}^s, c \in \mathbb{R}$ - Variablen $b_{1}, \dots ,b_{n}$ zu $t_{1},\dots,t_{n}$ Bei 1 Dimension: $b_{k}=dt_{k}+c$ mit Messfehlern: $r_{k}=dt_{k}+c-b_{k}$ - r ist *Residuum* (vektor) According to def [[#5.2 Lösung mit der Normalgleichung|5.1.0.2]], we want to minimize the euclidean norm of the residuum:\min_{p \in \mathbb{R}^n,q \in \mathbb{R}} { |r_{1}|^2 +\dots+|r_{m}|^2} = \min_{p \in \mathbb{R}^n,q \in \mathbb{R}} \sum_{i=1}^s |p^\top t_{i}+q-b_{i}|^2 = \min_{p \in \mathbb{R}^n,q \in \mathbb{R}} \sum_{i=1}^s | 1\cdot q+t_{i}^\top p+q-b_{i}|^2$$ we can also write the equations as , where
which can be minimized:
5.2 Lösung mit der Normalengleichung
todo herleitung lesen
Das LGS aus 5.1 kann folgendermassen mit der Normalengleichung gelöst werden.
Def 5.2.0.1 Normalengleichung
Satz 5.2.0.2. Lösung der Ausgleichsrechnung mit der Normalengleichung
Sei eine Matrix gegeben. Falls der Rang dieser Matrix gleich ist, so ist invertierbar. In diesem Fall hat die Normalengleichung also genau eine Lösung, die die Lösung des linearen Ausgleichsproblems ist.
Probleme mit der Normalengleichung
- normalerweise stimmt nicht -> Normalengleichung nicht anwendbar
- Falls Spalten/Zeilen numerisch abhängig sind, gibt es grosse Fehler im Ergebnis
-> Stattdessen wird normalerweise die Singulärwertszerlegung benutzt todo link einfügen
5.3 Lösung mit der QR-Zerlegung
Alternativ zur Normalengleichung kann man die QR-Zerlegung verwenden:
Wenn Rang hat, hat gleichen Rang -> ist invertierbare obere Dreiecksmatrix mit ersten Zeilen. Q ist orthogonal, . Dann haben wir:
da . Nun können wir ausrechnen:
todo ausführlichere Erklärung lesen
???
orthogonale Matrizen haben die Eigenschaft
6 Determinanten
Deteminante von einer Matrix:
Eigenschaften von ():
6.1 Definition und Eigenschaften
Def 6.1.0.1. Multilineare Abbildung
Seien 𝑉 und 𝑊 zwei lineare Räume. ist eine lineare Abbildung falls . ist eine bilineare Abbildung falls linear in jedem der beiden Argumente ist. ist eine multilineare Abbildung falls linear in jedem Argument ist.
Def 6.1.0.3 Determinante
Die Determinante ist eine Funktion
mit folgenden Eigenschaften
- (D1)
- (D2) wechselt das Vorzeichen, wenn zwei Zeilen oder Spalten vertauscht werden (Antisymmetrie)
- (D3) ist linear in jeder Zeile und Spalte:
\begin{align} \det \begin{bmatrix} ta & tb\c & d \end{bmatrix} &= t\cdot \begin{bmatrix} a & b\c & d \end{bmatrix} \ \det \begin{bmatrix} a+\tilde{a} & b+\tilde{b}\c & d \end{bmatrix} &= \det \begin{bmatrix} a & b \c & d \end{bmatrix} + \det \begin{bmatrix} \tilde{a} & btilde \ c & d \end{bmatrix} \end{align}
Bem
- beschreibt eine eindeutige Abbildung
- In der Praxis ist die Def. schwierig anwendbar, aber wir können folgende Eigenschaften daraus herleiten:
- zwei Spalten/Zeilen von identisch
- lin.Komb. von Zeilen von Matrix ändern die Determinante dieser Matrix nicht.
- hat Nullzeilen/Nullspalten
- Dreiecksmatrix ist Produkt der Diagonaleinträge
- singulär (keine Inverse todo überprüfen) durch Gauss-elimination entsteht Nullzeile wegen (6)
- wenn A inv.bar
- Entwicklung der ersten Zeile:
- wächst exponentionell für -> Gauss-elimination wächst schlimmstenfalls mit -> Eigenschaft nur für Handrechung gedacht (oder Theorie)
Bsp
Determinante mit Gauss berechnen
Sei die obere/untere Diagonalmatrix, die mit Gauss-elimination aus hervorgeht. Dann ist das Produkt der Diagonaleinträge =
- ist wegen möglich
- vertauschen von Zeilen/Spalten wechselt das Vorzeigen
7 Eigenwerte
7.1 Motivation
emptiness
7.2 Eigenwerte und Eigenvektoren
Bem In diesem Kapitel arbeiten wir mit (quadratischen) Matrizen.
Sei ein linearer Raum und lineare Abbildung.
Def 7.2.0.2. Eigenwertproblem
heisst Eigenwert der Matrix , falls es ein gibt, sodass . heisst dann Eigenvektor von zum Eigenwert .
todo diagonalmatrix
Def. 7.1.0.4 Diagonalisierung
diagonalisierbar falls es gibt invertierbar sodass
Satz 7.2.0.3. Wenn eine Matrix diagonalisierbar ist, dann sind die Elemente auf der Diagonale von Eigenwerte und die Spalten von sind die entsprechenden Eigenvektoren.
Def. 7.1.0.5 Ähnlichkeit
Zwei Matrizen sind ähnlich, falls eine invertierbare Matrix existiert, sodass
Bem Wenn diagonalisierbar mit , dann:
Dann sind EW von und EV von
Theorem
Sei Matrix mit lin. unabhängigen EV und seien diese als Spalten einer Matrix geschrieben: . Dann ist
\lambda_{1}&&&0\ & \lambda_{2} \ && \dots \ 0&&& \lambda_{n} \end{bmatrix} = D
mit $\lambda_{1}, \lambda_{2},\dots,\lambda_{n}$ EW von $A$.
Theorem
- Sei mit EW, die sich alle unterscheiden. Dann sind die entsprechenden EV linear unabhängig.
- Konsequenz: Wenn Matrix hat unterschiedliche EW, dann ist diagonalisierbar.
Bem todo fü jede aus einer Vektornorm! (später:) todo
Def Gershgorin-Kreis
Def Gershgorin-Gebiet
D_{A}=#todo
Theorem
Alle EW von liegen in .
Bem: Es gibt für LGS nicht-triviale Lösungen EW von .
Bem: Wenn EW ausschliessen können, dann ist invertierbar. -> ist invertierbar
Def strikt diagonaldominant
Matrix heisst strikt diagonaldominant, wenn
|a_{ii}|> |a_{i1}|+|a_{i2}|+\dots+ #todo
Theorem
strikt diagonaldominant () invertierbar.
- gilt nicht in andere Richtung
Bsp todo (?)
komplexe EW
reele Matrizen knnen echt komplexe haben. Diese kommen immer paarweise: sind beide .
Bem EV ist nicht eindeutig Sei EW,EV von => mit beliebig auch von
Def 7.2.0.7. Charakteristische Gleichung
Um die Eigenwerte einer Matrix auszurechnen, bedienen wir uns der Gleichung
Theorem
Jedes Polynom von Grad hat Nullstelle in (mehrfache Nullstellen auch gezählt).
Satz 7.2.0.9. Existenz und Anzahl der Eigenwerte einer Matrix
Jede Matrix hat mindestens einen Eigenwert und kann maximal verschiedene Eigenwerte haben.
Bem das Produkt der Pivote ist auch das Produkt der Eigenverte
Bem für gibt es keine geschlossene Formel für die Nullstellen -> die Eigenwerte müssen approximiert werden
Satz 7.2.0.26. Ähnliche Matrizen haben gleiche Eigenwerte
Ähnliche Matrizen haben das gleiche charakteristische Polynom. Sie haben also die gleichen Eigenwerte mit den gleichen algebraischen Multiplizitäten.
Satz 7.2.0.27. Multiplizitätsregel
Für die verschiedenen Multiplizitäten eines Eigenwerts gilt:
7.3 Symmetrische Matrizen
Satz 7.3.0.1. Eigenschaften Symmetrische Matrizen
Sei eine symmetrische () Matrix. Dann
- alle Eigenwerte von reel
- alle Eigenvektoren von orthogonal
- alle symmetrischen Matrizen sind normal
Bem 7.3.0.2 Strukturierte Matrizen, spezielle Eigenwerte Die Menge der Eigenwerte hängt vom Verhältnis zwischen und ab:
-> auch bei diesen Matrizen sind die Eigenvektoren orthogonal zueinander.
Definition 7.3.0.3. Normale Matrix
Satz 7.3.0.5
hat orthogonale Eigenvektoren normal
Satz 7.3.0.6 Spektralsatz
Jede symmetrische Matrix lässt sich durch orthogonale Transformationen diagonalisieren.
-> es gibt eine orthogonale (unitäre) Matrix und eine diagonale Matrix , sodass
Bemerkung 7.3.0.7 (Normale Matrizen sind Summen von unitären/orthogonalen Projektoren) Sei eine symmetrische (normale) Matrix. Dann lässt sie sich wegen dem Spektralsatz durch unitäre/orthogonale Transformationen diagonalisieren:
dann
Bemerkung 7.3.0.8 (Diagonalisierbare Matrizen sind Summen von (schiefen) Projektoren) Falls eine matrix nur diagonalisierbar ist:
das heisst auch ( ist ein schiefer Projektor, nicht orthogonal):
Bem
- todo vorlesung anschauen (@2024-12-28) -> unverständlich im aufschrieb
gilt nicht, falls normal, aber nicht symmetrisch
Optimierung für symmetrische Matrizen
- vorlesung anschauen (@2024-12-28) -> unverständlich im Aufschrieb
Satz 7.3.0.9. Euklidische Norm und Eigenwerte
\begin{align} 1.\quad & ||A||{2} = \sqrt{ \max{ d; d~\text{EW von}~A^HA } } & \text{für jede quadratische Matrix} \ 2.\quad & ||U||{2}=1 & \text{für jede U orthogonal/unitär} \ 3.\quad & ||A||_{2} = \max{ |\lambda|; \lambda \text{~EW von }A } & \text{für jede A symmetrisch} \end{align}
> [!note] Satz 7.3.0.10. Die Eigenwerte der inversen Matrix > > $$ \begin{align} 1.\quad & ||A^{-1}||_{2} = \frac{1}{\inf_{||y||_{2}=1}||Ay||_{2}} = \frac{1}{\min \{ d, d~\text{EW von}~A^HA \}} & \text{A invertierbar}\\ 2.\quad & ||A^{-1}||_{2} = \frac{1}{\min\{ |\lambda|, \lambda~\text{EW von}~A \}} & \text{A invertierbar, symmetrisch} \end{align} > $$ > Der kleinste EW von $A^HA$ / $A$ ist strikt positiv. > [!tip] Definition 7.3.0.11. Konditionszahl > > Die Konditionszahl einer **invertierbaren** Matrix $A$ ist > $$ > k(A)=||A^{-1}||_{2}||A||_{2} = \sqrt{ \frac{d_{\max}}{d_{\min}} } > $$ > Die Konditionszahl einer **invertierbaren, symmetrischen** Matrix $A$ ist > $$ > k(A) = ||A^{-1}||_{2}||A||_{2} = \sqrt{ \frac{|\lambda_{\max}|}{|\lambda_{\min}|} } > $$ > wobei $d_{\max}$ grösster EW, $d_{\min}$ kleinnster EW von $A$ **Bem** #todo Vorlesung Anschauen; Aufschrieb unleserlich ## 7.4 Symmetrisch positive Matrizen > [!tip] Definition 7.4.0.3. Symmetrisch positiv-definite Matrizen > > $$ \begin{align} (1)\quad & x^\top Ax\geq 0 ~\text{für alle}~x \in \mathbb{R}^n \\ (2)\quad & x^\top Ax = 0 \implies x=0 \end{align} > $$ > Für eine symmetrische, quadratische Matrix $A$ > 1. **symmetrisch positiv-definit (s.p.d)** $\iff$ (1) und (2) > 2. **symmetrisch positive semi-definit** $\iff$ nur (1) > [!note] Satz 7.4.0.5. Eigenwerte einer s.p.d. Matrix > > symmetrische Matrix $A$ ist positiv-definit $\iff$ ale EW strikt positiv **Bem** Eine spd Matrix $A$ ergibt:\left< x,y \right>_{A} = x^\top Ay
**Bem 7.4.0.6** (S.p.d.-Test via Pivote.) Wenn die Gauss-Elimination einer symmetrischen, quadratischen Matrix (strikt) positive Pivote hat, dann ist die Matrix positiv definit. #todo anwendung nicht verstanden #todo Vervollständigen ## 7.5 Fourier-Matrix Sei $n\geq2$ $m\times n$ zirkulante Matrixc = \begin{bmatrix} c_{0} & c_{1} & c_{2} & \dots & c_{n-1} & c_{n-1} \ c_{m-1} & c_{0} & c_{1} & \dots & c_{n-3} & c_{n-2} \ & & \ddots & \ddots & & \ & & & & & c_{1} \ c_{1} & c_{2} & c_{3} & \dots & c_{n-1} & c_{0} \end{bmatrix}
S_{n} = \begin{bmatrix} 0 & 1 & 0 & \dots & 0 \ 0 & 0 & 1 & \dots & 0 \ \vdots & & & \ddots \ & & & & 1 \ 1 & 0 & 0 & 0 & 0 \end{bmatrix}
=> $S_{n}^\top S_{n}=I_{n}$ => diagonalisierbar mit unitären Transformation Sei $v \in V$ EV zum EW $\lambda$ von $S_{n}$ #todo Seien $A,B~n\times n$ diagonalisierbare Matrizen **Theorem** (a) $A,B$ gleichzeitig diagonalisierbar $\implies AB=BA$ (b) falls alle $EW$ von $A,B$ haben $AM~1$, dann aus $AB=BA \implies A,B$ gleichzeitig diagonalisierbar problem von Jordan-Zerlegung: Schnur-Zerlegung ist unitäre Matrix -> keine Rundungsfehler (ONB), hier Rundungsfehler #todo vervollständigen